Tính độc nhất của nội dung luôn là một trong những yếu tố cốt lõi quyết định sự thành bại của một chiến dịch tối ưu hóa công cụ tìm kiếm. Khi xây dựng website, nhiều quản trị viên thường chỉ tập trung vào việc sản xuất bài viết mới mà bỏ qua khâu kiểm soát cấu trúc kỹ thuật, dẫn đến tình trạng hệ thống tự động sinh ra hàng loạt trang có nội dung giống nhau. Hiểu rõ bản chất của vấn đề này và biết cách xử lý chuẩn kỹ thuật là bước bắt buộc để bảo vệ thứ hạng website của bạn.
Duplicate Content là gì
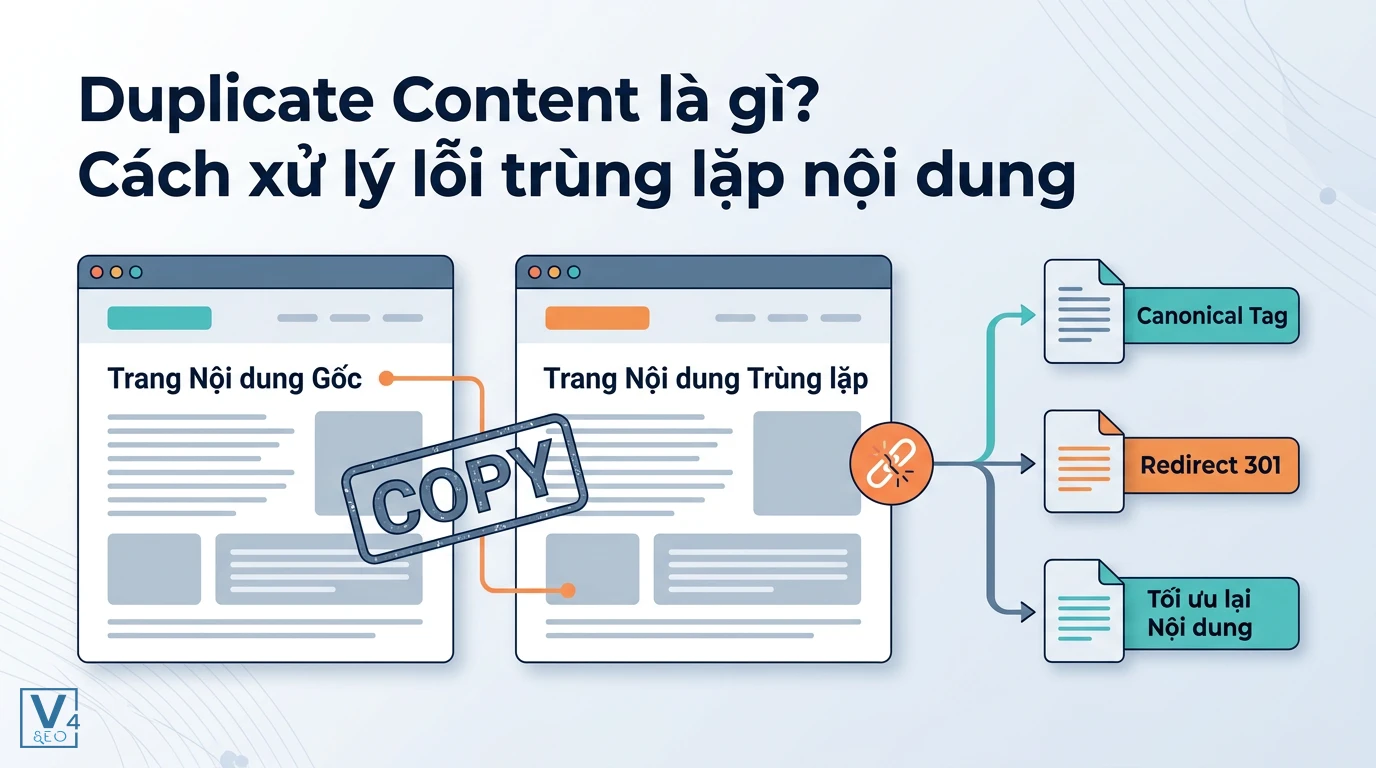
Duplicate content (nội dung trùng lặp) là tình trạng một đoạn nội dung giống hệt hoặc gần như tương đồng xuất hiện tại nhiều địa chỉ URL khác nhau trên Internet. Vấn đề này có thể xảy ra ngay trong nội bộ một website hoặc giữa các website khác nhau, gây khó khăn cho công cụ tìm kiếm trong việc xác định phiên bản gốc để lập chỉ mục và xếp hạng.
Theo công bố từ các chuyên gia của Google, có khoảng 25% đến 30% nội dung trên Internet là trùng lặp. Tuy nhiên, cần phân biệt rõ giữa lỗi trùng lặp nội dung kỹ thuật và hành vi đạo văn (plagiarism). Đạo văn là việc cố ý sao chép chất xám của người khác, trong khi phần lớn lỗi duplicate content lại xuất phát từ các thiết lập hệ thống vô ý của chính chủ website.
Trùng lặp nội dung nội bộ
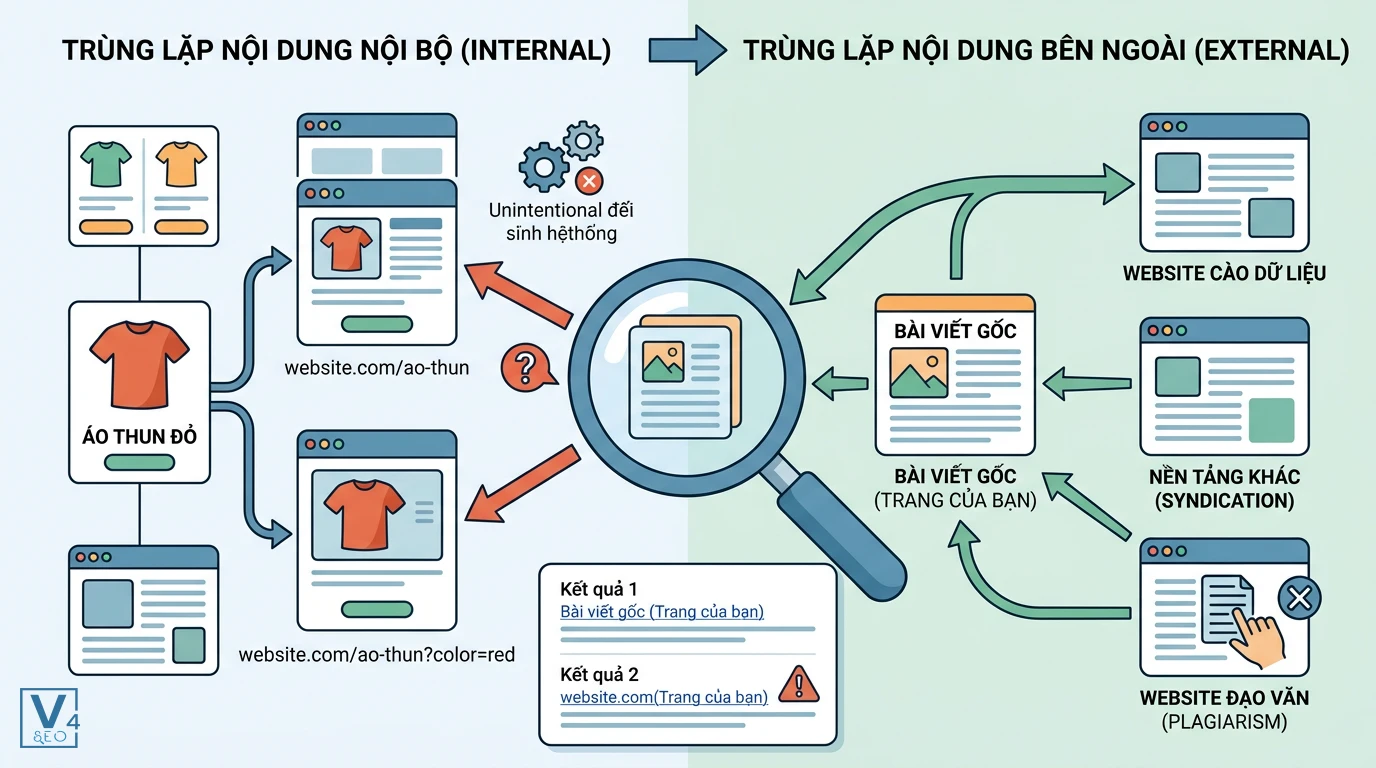
Trùng lặp nội dung nội bộ (Internal Duplicate Content) xảy ra khi nhiều URL trên cùng một tên miền hiển thị nội dung giống nhau. Đây là dạng lỗi phổ biến nhất đối với các trang thương mại điện tử hoặc blog có cấu trúc danh mục phức tạp.
Ví dụ, một sản phẩm áo thun có thể được truy cập qua hai đường dẫn khác nhau do bộ lọc màu sắc: website.com/ao-thun và website.com/ao-thun?color=red. Mặc dù người dùng chỉ thấy một sản phẩm, Googlebot lại ghi nhận đây là hai trang riêng biệt có nội dung trùng lặp hoàn toàn.
Trùng lặp nội dung bên ngoài
Trùng lặp nội dung bên ngoài (External Duplicate Content) là hiện tượng nội dung của bạn xuất hiện trên các tên miền khác. Tình trạng này thường xảy ra do bài viết bị các trang web khác tự động cào dữ liệu (scraped content) trái phép, hoặc do bạn chủ động phân phối nội dung (syndication) lên các nền tảng báo chí, mạng xã hội mà không khai báo nguồn gốc rõ ràng.
Tác hại của Duplicate Content đối với chiến dịch SEO
Trùng lặp nội dung không trực tiếp dẫn đến hình phạt thủ công từ Google (trừ trường hợp cố ý spam), nhưng nó sẽ làm suy giảm nghiêm trọng hiệu suất SEO tổng thể do lãng phí tài nguyên thu thập dữ liệu và phân tán sức mạnh liên kết.
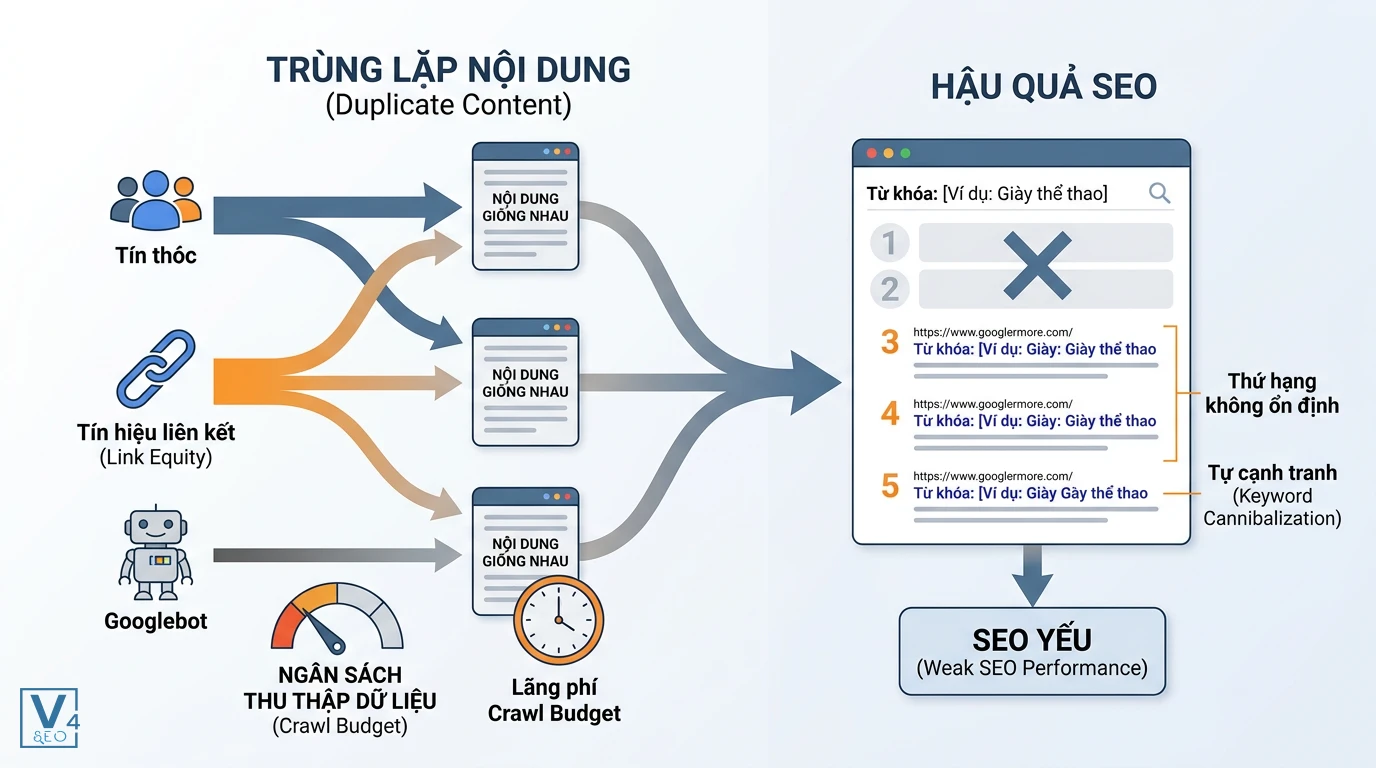
- Lãng phí ngân sách thu thập dữ liệu (Crawl Budget): Googlebot có một giới hạn thời gian nhất định để quét website của bạn. Nếu phải quét qua hàng trăm URL trùng lặp, bot sẽ bỏ lỡ các bài viết mới và quan trọng.
- Phân tán sức mạnh liên kết (Link Equity): Thay vì tập trung toàn bộ tín hiệu xếp hạng (backlink, traffic) vào một trang duy nhất, sức mạnh này bị chia nhỏ cho nhiều URL phụ, khiến không trang nào đủ mạnh để cạnh tranh vị trí top đầu.
- Gây hiện tượng ăn thịt từ khóa (Keyword Cannibalization): Khi có quá nhiều trang giống nhau, Google sẽ bối rối không biết nên chọn trang nào để hiển thị cho truy vấn của người dùng. Kết quả là các trang tự cạnh tranh lẫn nhau và cùng bị đẩy xuống thứ hạng thấp.
- Giảm trải nghiệm người dùng: Việc người dùng liên tục gặp lại một nội dung khi bấm vào các liên kết khác nhau sẽ làm giảm độ uy tín của thương hiệu.
Nguyên nhân phổ biến gây ra lỗi trùng lặp nội dung
Hầu hết các lỗi trùng lặp nội dung không xuất phát từ việc sao chép cố ý mà bắt nguồn từ cấu hình kỹ thuật website không chuẩn xác hoặc thói quen vận hành hệ thống quản trị nội dung (CMS).
Sự thiếu nhất quán trong cấu trúc URL là nguyên nhân hàng đầu. Việc website có thể truy cập đồng thời bằng cả phiên bản có WWW và không có WWW, hoặc HTTP và HTTPS mà không có lệnh chuyển hướng sẽ tạo ra các bản sao toàn hệ thống. Tương tự, việc thêm dấu gạch chéo (/) ở cuối URL (website.com/page và website.com/page/) cũng khiến Google hiểu lầm đây là hai trang khác biệt.
Bên cạnh đó, việc sử dụng tham số URL (URL parameters) cho các tính năng như bộ lọc tìm kiếm, sắp xếp sản phẩm hoặc theo dõi chiến dịch (UTM tags) thường xuyên sinh ra hàng loạt liên kết động chứa nội dung y hệt trang gốc. Các hệ thống CMS như WordPress cũng dễ tự động tạo ra các trang chuyên mục (category) hoặc thẻ (tag) gom nhóm bài viết, vô tình tạo ra các trang danh sách có nội dung lặp lại.
Để tránh tình trạng cạn kiệt ý tưởng dẫn đến việc viết các bài gần giống nhau (near duplicate content), bạn nên tham khảo Cách xây dựng dàn ý content chuẩn SEO ngay từ giai đoạn lập kế hoạch. Việc phân bổ chủ đề rõ ràng sẽ giúp mỗi URL mang một giá trị thông tin độc nhất.
Cách kiểm tra và phát hiện Duplicate Content nhanh chóng
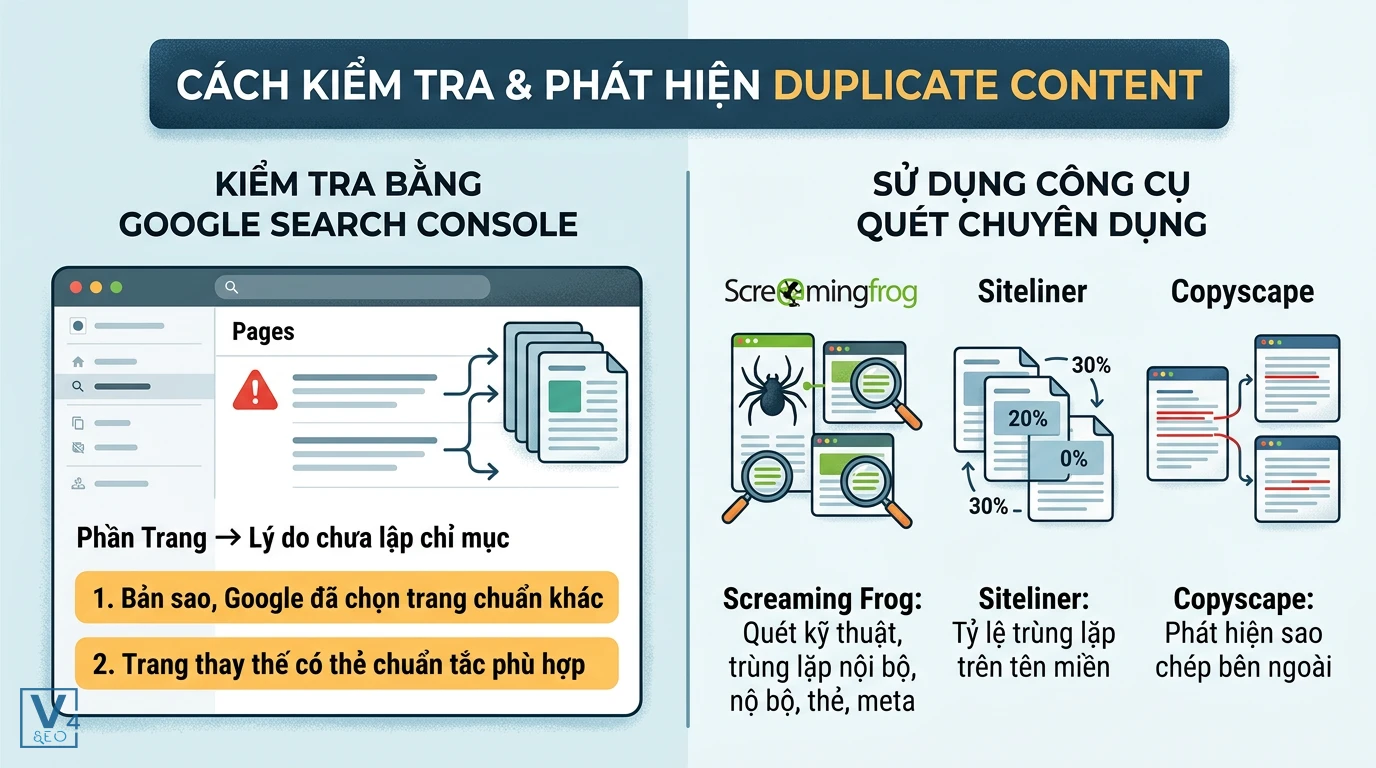
Quản trị viên có thể sử dụng kết hợp các toán tử tìm kiếm nâng cao, báo cáo miễn phí từ Google và các phần mềm quét chuyên dụng để rà soát toàn diện lỗi trùng lặp trên hệ thống.
Kiểm tra bằng Google Search Console
Đây là công cụ chính xác nhất để xem cách Google đánh giá các URL trên website của bạn. Trong giao diện Google Search Console, hãy truy cập vào mục Trang (Pages) và tìm đến phần lý do trang chưa được lập chỉ mục.
Bạn cần đặc biệt chú ý đến hai thông báo: “Bản sao, Google đã chọn một trang chuẩn khác với lựa chọn của người dùng” và “Trang thay thế có thẻ chuẩn tắc phù hợp”. Các báo cáo này sẽ liệt kê chính xác những URL nào đang bị Google gộp chung do trùng lặp nội dung, giúp bạn dễ dàng đối chiếu và xử lý.
Sử dụng công cụ quét chuyên dụng
Các công cụ bên thứ ba giúp quét nhanh toàn bộ website hoặc so sánh nội dung của bạn với các đối thủ trên thị trường:
- Screaming Frog SEO Spider: Phần mềm cào dữ liệu kỹ thuật mạnh mẽ giúp phát hiện các URL trùng lặp thẻ tiêu đề, thẻ meta, hoặc trùng lặp nội dung nội bộ dựa trên tỷ lệ phần trăm giống nhau.
- Siteliner: Công cụ trực tuyến miễn phí giúp quét nhanh các trang trên cùng một tên miền để tìm ra tỷ lệ nội dung lặp lại giữa các bài viết.
- Copyscape: Giải pháp hàng đầu để kiểm tra trùng lặp nội dung bên ngoài. Bạn chỉ cần nhập URL, hệ thống sẽ trả về danh sách các trang web đang sao chép bài viết của bạn.
Giải pháp khắc phục triệt để lỗi trùng lặp nội dung
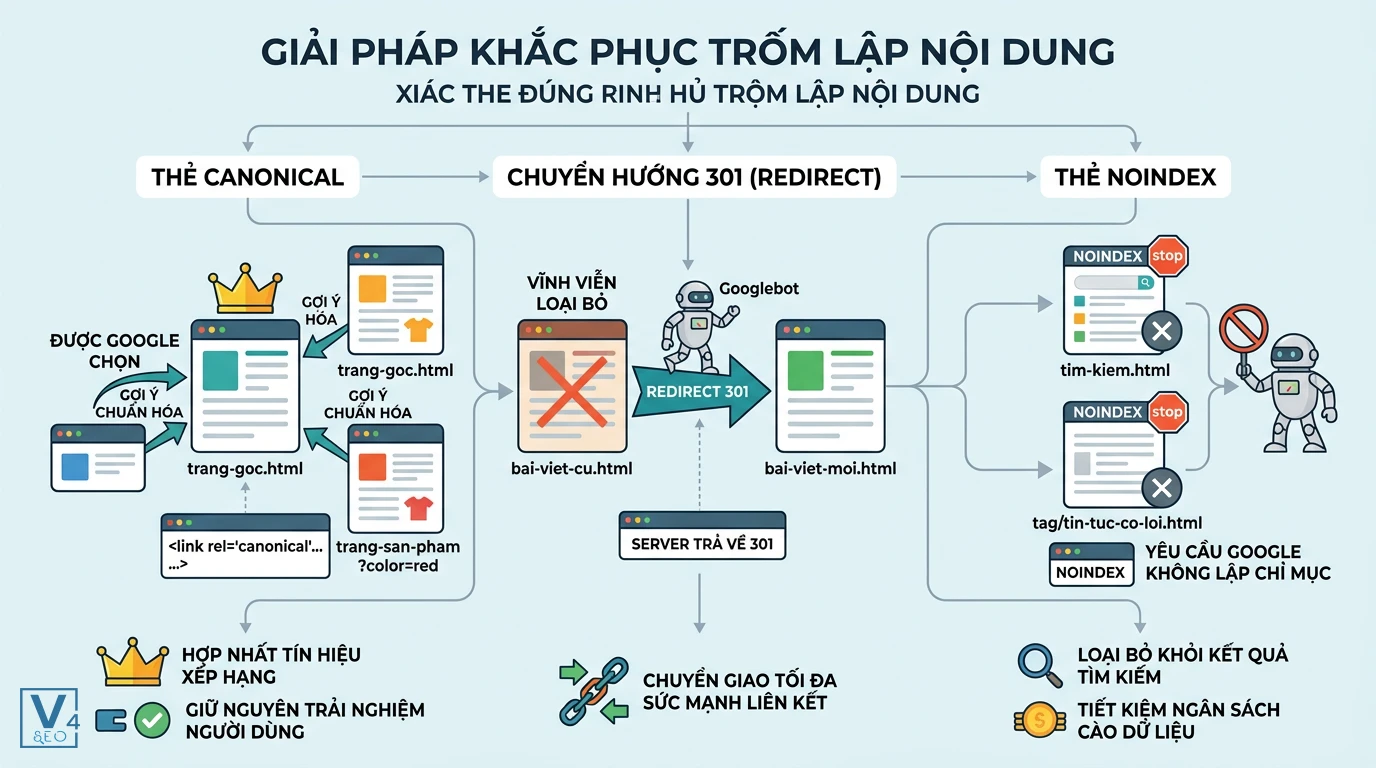
Tùy thuộc vào nguyên nhân cốt lõi, bạn có thể áp dụng các phương pháp kỹ thuật như thiết lập chuyển hướng, khai báo thẻ chuẩn hóa hoặc cấu hình lại hệ thống để xử lý dứt điểm tình trạng đa URL.
|
Giải pháp |
Cách hoạt động |
Trường hợp áp dụng tối ưu |
Tác động đến SEO |
|
Thẻ Canonical |
Gợi ý cho Google biết đâu là phiên bản URL gốc cần được ưu tiên xếp hạng. |
Các trang biến thể sản phẩm, trang có tham số bộ lọc, tham số theo dõi UTM. |
Hợp nhất tín hiệu xếp hạng về trang gốc, giữ nguyên trải nghiệm người dùng trên các trang phụ. |
|
Redirect 301 |
Chuyển hướng vĩnh viễn người dùng và bot tìm kiếm từ URL cũ sang URL mới. |
Hợp nhất phiên bản HTTP/HTTPS, WWW/non-WWW, hoặc khi xóa bỏ bài viết cũ. |
Chuyển giao tối đa sức mạnh liên kết (Link Equity) sang trang đích mới. |
|
Thẻ Noindex |
Yêu cầu công cụ tìm kiếm không lập chỉ mục trang web này vào cơ sở dữ liệu. |
Các trang chính sách nội bộ, trang kết quả tìm kiếm trên site, trang tag kém chất lượng. |
Loại bỏ trang khỏi kết quả tìm kiếm, tiết kiệm ngân sách cào dữ liệu. |
Sử dụng thẻ Canonical
Thẻ Canonical (thẻ chuẩn hóa) giúp giữ lại tất cả các trang hoạt động bình thường cho người dùng truy cập, nhưng chỉ định một trang duy nhất để Google lập chỉ mục. Cú pháp chuẩn được đặt trong phần của HTML như sau: .
Theo kinh nghiệm thực chiến từ đội ngũ kỹ thuật V4SEO, bạn nên thiết lập thẻ Canonical tự tham chiếu (self-referencing canonical) cho mọi trang chuẩn trên website để phòng ngừa việc các hệ thống khác tự động gắn thêm tham số vào URL của bạn.
Thiết lập chuyển hướng 301
Redirect 301 là giải pháp tốt nhất khi bạn muốn loại bỏ hoàn toàn các URL phụ và điều hướng luồng truy cập về một trang chính. Đảm bảo máy chủ phản hồi mã trạng thái chính xác (ví dụ 200 OK cho trang chuẩn, 301 cho trang chuyển hướng) thay vì trả về các mã lỗi hoặc Mã phản hồi 204 No Content khiến bot tìm kiếm bối rối.
Trong quá trình thu thập dữ liệu, Googlebot có thể yêu cầu tải từng phần tài nguyên. Việc hiểu rõ Ý nghĩa của trạng thái 206 Partial Content sẽ giúp bạn tối ưu hóa tốc độ phản hồi của máy chủ, từ đó kết hợp với Redirect 301 để điều hướng dòng chảy sức mạnh SEO một cách mượt mà nhất.
Câu hỏi thường gặp
Google có thực sự phạt website bị trùng lặp nội dung không
Google không có hình phạt (penalty) chính thức cho lỗi trùng lặp nội dung thông thường, trừ khi đó là hành vi cố ý cào dữ liệu hoặc spam quy mô lớn nhằm thao túng thứ hạng. Tuy nhiên, Google sẽ tự động lọc (filter) và chỉ hiển thị một phiên bản tối ưu nhất, khiến các trang trùng lặp còn lại bị mất hoàn toàn cơ hội tiếp cận người dùng.
Tại sao tự viết nội dung vẫn bị báo lỗi trùng lặp
Nguyên nhân thường do cấu trúc URL của website chưa được tối ưu. Hệ thống CMS có thể tự động sinh ra nhiều đường dẫn khác nhau cho cùng một bài viết (ví dụ: URL chứa danh mục, URL chứa thẻ tag, URL có tham số tìm kiếm). Dù bạn tự viết 100%, Google vẫn nhìn thấy nhiều bản sao của bài viết đó trên hệ thống của bạn.
Nên lựa chọn thẻ Canonical hay chuyển hướng Redirect 301
Hãy dùng Redirect 301 khi bạn muốn loại bỏ hoàn toàn URL cũ và chuyển hướng người dùng sang trang mới. Ngược lại, hãy dùng thẻ Canonical khi bạn muốn giữ lại cả hai URL cho người dùng trải nghiệm (như các bộ lọc màu sắc sản phẩm) nhưng chỉ muốn Google lập chỉ mục một trang duy nhất.
Nội dung do trí tuệ nhân tạo AI tạo ra có bị tính là trùng lặp
Nếu nội dung AI tạo ra không được biên tập lại, thiếu chiều sâu và có cấu trúc thông tin y hệt các nguồn dữ liệu phổ biến trên mạng, Google có thể đánh giá đó là nội dung mỏng (thin content) hoặc trùng lặp ý tưởng. Để an toàn, nội dung AI cần được bổ sung góc nhìn chuyên gia, ví dụ thực tế và giá trị thông tin độc nhất (information gain).
Cách xử lý tối ưu khi phát hiện đối thủ sao chép nội dung
Khi phát hiện bị sao chép, bước đầu tiên là liên hệ trực tiếp với quản trị viên trang web đó để yêu cầu gỡ bỏ hoặc thêm thẻ Canonical trỏ về bài viết gốc của bạn. Nếu họ không hợp tác, bạn có thể thu thập bằng chứng và gửi báo cáo vi phạm bản quyền (DMCA) thông qua công cụ hỗ trợ của Google để yêu cầu gỡ bỏ URL vi phạm khỏi kết quả tìm kiếm.