Quản lý tài nguyên website và điều hướng các công cụ tìm kiếm là một trong những nhiệm vụ quan trọng nhất của Technical SEO. Trong đó, file robots.txt đóng vai trò như một “người gác cổng” thông minh, giúp bạn kiểm soát chính xác những khu vực nào trên website được phép hoặc không được phép thu thập dữ liệu. Việc cấu hình chuẩn xác tệp tin này không chỉ giúp tối ưu hóa điểm chạm với Googlebot mà còn bảo vệ máy chủ trước làn sóng bot AI ngày càng mạnh mẽ.
Khái niệm file robots.txt là gì
Robots.txt là một tệp văn bản đơn giản (.txt) nằm ở thư mục gốc của website, đóng vai trò như một bộ quy tắc hướng dẫn các công cụ tìm kiếm (như Googlebot) biết những trang hoặc thư mục nào chúng được phép hoặc không được phép thu thập dữ liệu (crawl).

Tệp cấu hình văn bản này là một phần của Giao thức loại trừ robot (Robots Exclusion Protocol – REP). Khi một bot tìm kiếm truy cập vào website, việc đầu tiên chúng làm là tìm kiếm và đọc file robots.txt. Dựa vào các chỉ thị bên trong, bot sẽ quyết định tiếp tục quét các đường dẫn hay bỏ qua chúng. Tệp này bắt buộc phải được đặt ở thư mục gốc (root directory), ví dụ như domain.com/robots.txt.
Vai trò quan trọng của robots.txt đối với SEO
Robots.txt giúp tối ưu hóa ngân sách thu thập dữ liệu (Crawl Budget) và bảo vệ tài nguyên máy chủ một cách hiệu quả.
Ngân sách thu thập dữ liệu là giới hạn số lượng trang mà bot tìm kiếm sẽ quét trên một website trong một khoảng thời gian nhất định. Đối với các website lớn hoặc trang thương mại điện tử, việc lãng phí ngân sách này vào các trang rác sẽ khiến nội dung quan trọng chậm được lập chỉ mục. Dưới đây là những vai trò cốt lõi của tệp tin này:
- Tối ưu hóa Crawl Budget bằng cách hướng bot tập trung vào các trang mang lại giá trị SEO.
- Ngăn chặn bot quét các trang quản trị nội bộ, trang giỏ hàng hoặc các trang có nội dung trùng lặp.
- Giảm tải cho máy chủ (server) khi có quá nhiều trình thu thập dữ liệu truy cập cùng lúc.
- Hỗ trợ khai báo sơ đồ trang web (Sitemap) giúp bot tìm kiếm và lập chỉ mục nội dung mới nhanh chóng hơn.
Các cú pháp cơ bản trong file robots.txt
Các lệnh cơ bản trong tệp tin này bao gồm User-agent, Disallow, Allow và Sitemap, giúp định hình toàn bộ quy tắc thu thập dữ liệu.
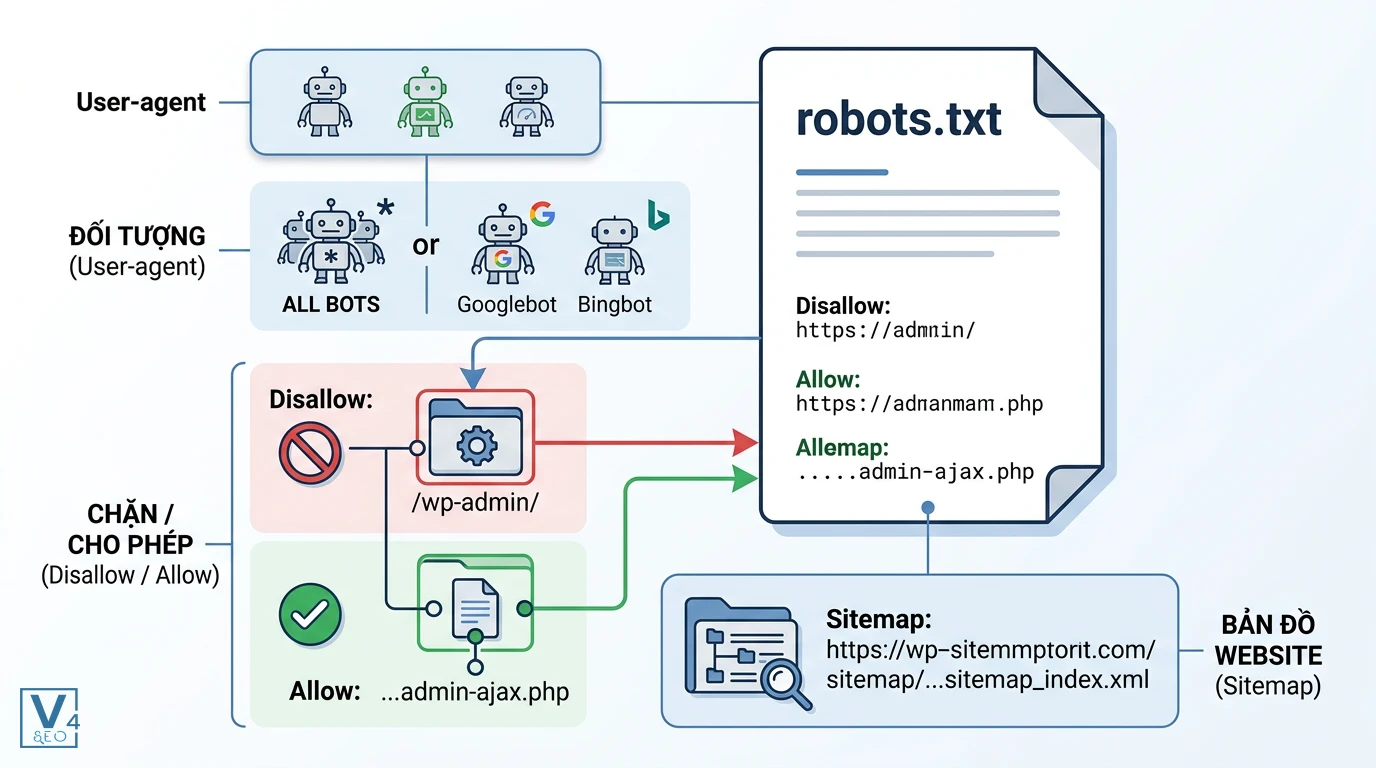
Để hiểu rõ Cách thiết lập cú pháp chuẩn trong file robots.txt, bạn cần nắm vững ý nghĩa và cách hoạt động của từng chỉ thị cốt lõi dưới đây.
Chỉ thị User-agent
Chỉ thị này xác định loại bot tìm kiếm cụ thể sẽ bị áp dụng quy tắc. Bạn có thể sử dụng ký tự đại diện * để áp dụng cho tất cả các bot, hoặc chỉ định đích danh một bot như Googlebot hay Bingbot.
User-agent: *
User-agent: Googlebot
Chỉ thị Disallow và Allow
Disallow dùng để chặn truy cập vào một đường dẫn hoặc thư mục, trong khi Allow dùng để cho phép truy cập vào một thư mục con nằm bên trong một thư mục đã bị chặn. Việc kết hợp hai lệnh này giúp bạn tinh chỉnh quyền truy cập một cách linh hoạt.
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Chỉ thị Sitemap
Lệnh này dùng để khai báo đường dẫn đầy đủ của file sitemap.xml để bot dễ dàng tìm thấy bản đồ website. Lệnh này thường được đặt ở cuối file và phải sử dụng URL tuyệt đối (bao gồm cả https://).
Sitemap: https://domain.com/sitemap_index.xml
Phân biệt robots.txt và thẻ meta robots
Điểm khác biệt lớn nhất là robots.txt kiểm soát việc thu thập dữ liệu (crawl), trong khi thẻ meta robots kiểm soát việc lập chỉ mục (index).

Nhiều người làm SEO thường nhầm lẫn giữa hai khái niệm này. Nếu bạn muốn tìm hiểu sâu hơn về Cơ chế hoạt động của X-Robots-Tag trong HTTP header, bạn cũng sẽ thấy sự khác biệt rõ rệt về cách xử lý của Googlebot. Dưới đây là bảng so sánh chi tiết:
|
Tiêu chí so sánh |
File robots.txt |
Thẻ Meta Robots |
|
Chức năng chính |
Chặn thu thập dữ liệu (Crawl) |
Chặn lập chỉ mục (Index) |
|
Vị trí cấu hình |
Tệp .txt độc lập ở thư mục gốc |
Thẻ HTML trong phần của trang |
|
Khả năng xuất hiện trên Google |
Trang vẫn có thể hiển thị trên kết quả tìm kiếm nếu có backlink trỏ về |
Trang bị loại bỏ hoàn toàn khỏi kết quả tìm kiếm (khi dùng noindex) |
|
Trường hợp sử dụng |
Tối ưu Crawl Budget, chặn quét thư mục hệ thống |
Ngăn Google hiển thị các trang cụ thể (trang cảm ơn, chính sách) |
Hướng dẫn cách tạo file robots.txt chuẩn SEO
Bạn có thể tạo file robots.txt bằng các trình soạn thảo văn bản đơn giản như Notepad hoặc sử dụng các công cụ hỗ trợ tích hợp sẵn trên nền tảng website.
Tạo file robots.txt thủ công
Sử dụng Notepad (trên Windows) hoặc TextEdit (trên Mac) để viết các dòng lệnh cơ bản. Tuyệt đối không sử dụng các phần mềm như Microsoft Word vì chúng có thể tự động chèn thêm các ký tự định dạng ẩn làm hỏng cấu trúc tệp. Sau khi soạn thảo, hãy lưu file với tên chính xác là robots.txt (viết thường toàn bộ) và định dạng mã hóa UTF-8. Cuối cùng, tải tệp này lên thư mục gốc của website thông qua FTP hoặc File Manager.
Tạo file robots.txt cho website WordPress
WordPress tự động tạo một file robots.txt ảo, nhưng để dễ dàng tùy chỉnh, bạn nên tạo file vật lý hoặc sử dụng các plugin SEO phổ biến như Rank Math hay Yoast SEO. Các plugin này cung cấp giao diện trực quan giúp bạn chỉnh sửa trực tiếp từ trang quản trị.
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php Sitemap: https://domain.com/sitemap_index.xml
Những sai lầm nghiêm trọng cần tránh khi dùng robots.txt
Cấu hình sai robots.txt có thể mang lại hậu quả nặng nề, thậm chí khiến toàn bộ nội dung website biến mất khỏi công cụ tìm kiếm.
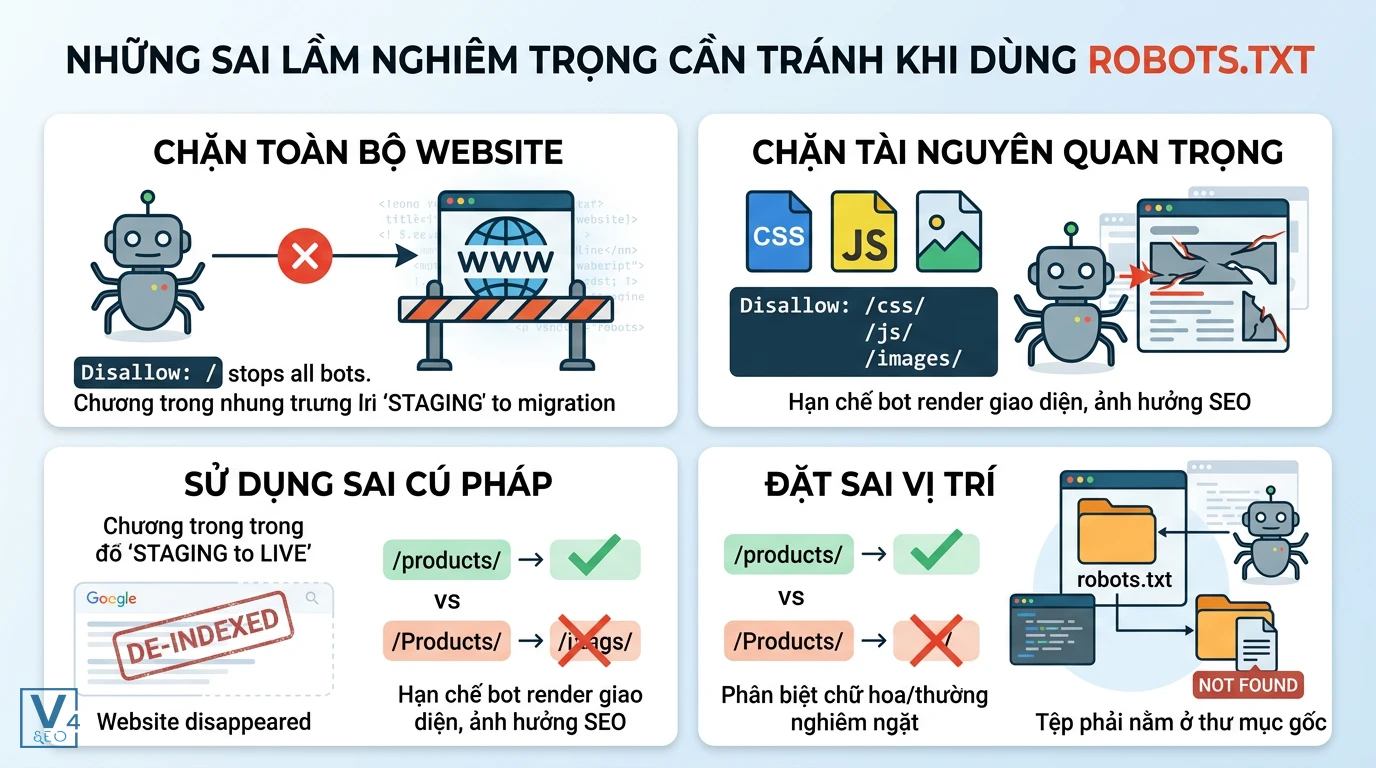
- Chặn toàn bộ website: Sử dụng lệnh Disallow: / sẽ ngăn chặn mọi bot truy cập vào trang web. Đây là lỗi phổ biến khi chuyển website từ môi trường thử nghiệm (staging) sang môi trường thực tế (live).
- Chặn các tệp tài nguyên quan trọng: Việc chặn thư mục chứa CSS, JavaScript hoặc hình ảnh sẽ khiến Googlebot không thể hiển thị (render) giao diện trang web một cách chính xác, dẫn đến đánh giá sai về trải nghiệm người dùng.
- Sử dụng sai cú pháp: Tệp robots.txt phân biệt chữ hoa và chữ thường rất nghiêm ngặt. Việc viết sai đường dẫn hoặc thiếu dấu gạch chéo có thể làm vô hiệu hóa toàn bộ quy tắc.
- Đặt sai vị trí: Tệp bắt buộc phải nằm ở thư mục gốc. Nếu bạn đặt nó trong một thư mục con, các công cụ tìm kiếm sẽ không thể tìm thấy và mặc định coi như website không có quy tắc hạn chế nào.
Nếu bạn đang gặp rắc rối với các cảnh báo trong Google Search Console, hãy tham khảo cách xử lý Lỗi Blocked by robots.txt thường gặp để khắc phục kịp thời.
Câu hỏi thường gặp
Làm thế nào để kiểm tra file robots.txt hoạt động thực tế?
Bạn có thể kiểm tra nhanh bằng cách gõ trực tiếp đường dẫn domain.com/robots.txt lên trình duyệt. Để kiểm tra chuyên sâu và phát hiện lỗi cú pháp, hãy sử dụng công cụ kiểm tra robots.txt được tích hợp bên trong Google Search Console.
Tại sao Google vẫn index trang khi đã chặn trong robots.txt?
Robots.txt chỉ chặn thu thập dữ liệu (crawl) chứ không chặn lập chỉ mục (index). Nếu một trang bị chặn nhưng lại nhận được liên kết (backlink) từ các trang web khác, Google vẫn có thể lập chỉ mục URL đó. Để giải quyết triệt để, bạn cần sử dụng thẻ meta robots với thuộc tính noindex.
Cách chặn các bot AI thu thập dữ liệu website
Nếu bạn muốn bảo vệ bản quyền nội dung trước các mô hình ngôn ngữ lớn, bạn có thể thêm các User-agent của bot AI (ví dụ: GPTBot, ClaudeBot) và sử dụng lệnh Disallow: /. Tuy nhiên, hãy cân nhắc kỹ vì điều này có thể làm giảm cơ hội website xuất hiện trong các câu trả lời tổng hợp của AI.
Quy tắc phân biệt chữ hoa chữ thường trong robots.txt
Có, tệp tin này phân biệt chữ hoa và chữ thường rất khắt khe. Ví dụ, đường dẫn /tin-tuc/ sẽ được hiểu hoàn toàn khác với /Tin-Tuc/. Bạn cần đảm bảo đường dẫn khai báo khớp chính xác với URL thực tế trên website.
Vị trí đặt file robots.txt hợp lệ trên website
File robots.txt bắt buộc phải nằm ở thư mục gốc (root directory) của tên miền. Bất kỳ vị trí nào khác (như thư mục con) đều khiến tệp tin trở nên vô tác dụng vì bot tìm kiếm sẽ không quét qua các khu vực đó để tìm quy tắc.
Việc cấu hình chuẩn xác tệp tin này đòi hỏi sự cẩn thận và am hiểu về hệ thống. Nếu bạn gặp khó khăn trong việc tối ưu Technical SEO hoặc cấu hình robots.txt, hãy liên hệ ngay với chuyên gia V4SEO để được hỗ trợ nhanh chóng và đảm bảo website luôn vận hành ở trạng thái tốt nhất.