Kiểm soát quá trình thu thập dữ liệu và lập chỉ mục là một trong những nền tảng quan trọng nhất của kỹ thuật SEO Onpage. Nếu Googlebot truy cập và lưu trữ những trang không mang lại giá trị như trang giỏ hàng, trang cảm ơn hay các trang nội dung mỏng, website của bạn sẽ lãng phí ngân sách thu thập dữ liệu (Crawl Budget) và đối mặt với nguy cơ bị phạt vì trùng lặp nội dung. Để giải quyết triệt để vấn đề này, các quản trị viên web cần nắm vững cách sử dụng thẻ meta robots.
Thẻ Meta Robots là gì
Thẻ Meta Robots (Robots Meta Tag) là một đoạn mã HTML nằm trong phần của mã nguồn HTML. Bên cạnh việc Khai báo bảng mã ký tự với thẻ meta charset để hiển thị đúng ngôn ngữ, việc khai báo thẻ meta robots là bước không thể thiếu để bảo vệ cấu trúc SEO của website.
Cú pháp và các thuộc tính phổ biến của Meta Robots
Cấu trúc chuẩn của thẻ meta robots bao gồm hai thuộc tính chính là name và content. Thuộc tính name xác định đối tượng áp dụng (thường là “robots” cho tất cả các bot hoặc “googlebot” chỉ dành riêng cho Google), trong khi content chứa các lệnh điều hướng cụ thể.
Ví dụ về cú pháp HTML chuẩn:
Thuộc tính index và noindex
Thuộc tính index cho phép các công cụ tìm kiếm đưa trang web vào cơ sở dữ liệu của họ để hiển thị trên kết quả tìm kiếm. Đây là giá trị mặc định, nghĩa là nếu bạn không khai báo thẻ meta robots, Google vẫn sẽ tự động lập chỉ mục trang (nếu không bị chặn bởi các yếu tố khác).
Ngược lại, thuộc tính noindex là một chỉ thị mạnh mẽ yêu cầu bot tìm kiếm không được lập chỉ mục trang này. Bạn nên sử dụng noindex cho các trang nội bộ, trang kết quả tìm kiếm nội bộ, trang giỏ hàng hoặc các trang đang trong quá trình thử nghiệm. Ngăn chặn lập chỉ mục trang với meta robots noindex là một kỹ thuật quan trọng giúp bảo vệ website khỏi lỗi trùng lặp nội dung (Duplicate Content).
Thuộc tính follow và nofollow
Thuộc tính follow cho phép bot tìm kiếm đi theo các đường link có trên trang để tiếp tục quá trình thu thập dữ liệu, đồng thời truyền sức mạnh liên kết (Link Equity) sang các trang đích. Tương tự như index, follow cũng là giá trị mặc định.
Thuộc tính nofollow yêu cầu bot không đi theo bất kỳ liên kết nào trên trang đó. Cần lưu ý sự khác biệt quan trọng: nofollow trong thẻ meta robots áp dụng cho toàn bộ các liên kết trên trang, trong khi thuộc tính rel=”nofollow” chỉ áp dụng cho một liên kết HTML cụ thể. Cách sử dụng thẻ meta robots nofollow để điều hướng bot là giải pháp hiệu quả khi bạn không muốn chia sẻ sức mạnh SEO cho các trang kém quan trọng.
Các thuộc tính nâng cao khác
Ngoài các thuộc tính cơ bản, thẻ meta robots còn hỗ trợ nhiều lệnh nâng cao giúp quản trị viên kiểm soát chi tiết hơn cách nội dung hiển thị trên trang kết quả tìm kiếm (SERP):
- noarchive: Ngăn công cụ tìm kiếm lưu trữ và hiển thị bản sao trong bộ nhớ cache của trang.
- nosnippet: Ngăn chặn việc hiển thị đoạn trích mô tả (meta description) bên dưới tiêu đề trên kết quả tìm kiếm.
- noimageindex: Yêu cầu bot không lập chỉ mục các hình ảnh xuất hiện trên trang đó.
Phân biệt Meta Robots và Robots.txt
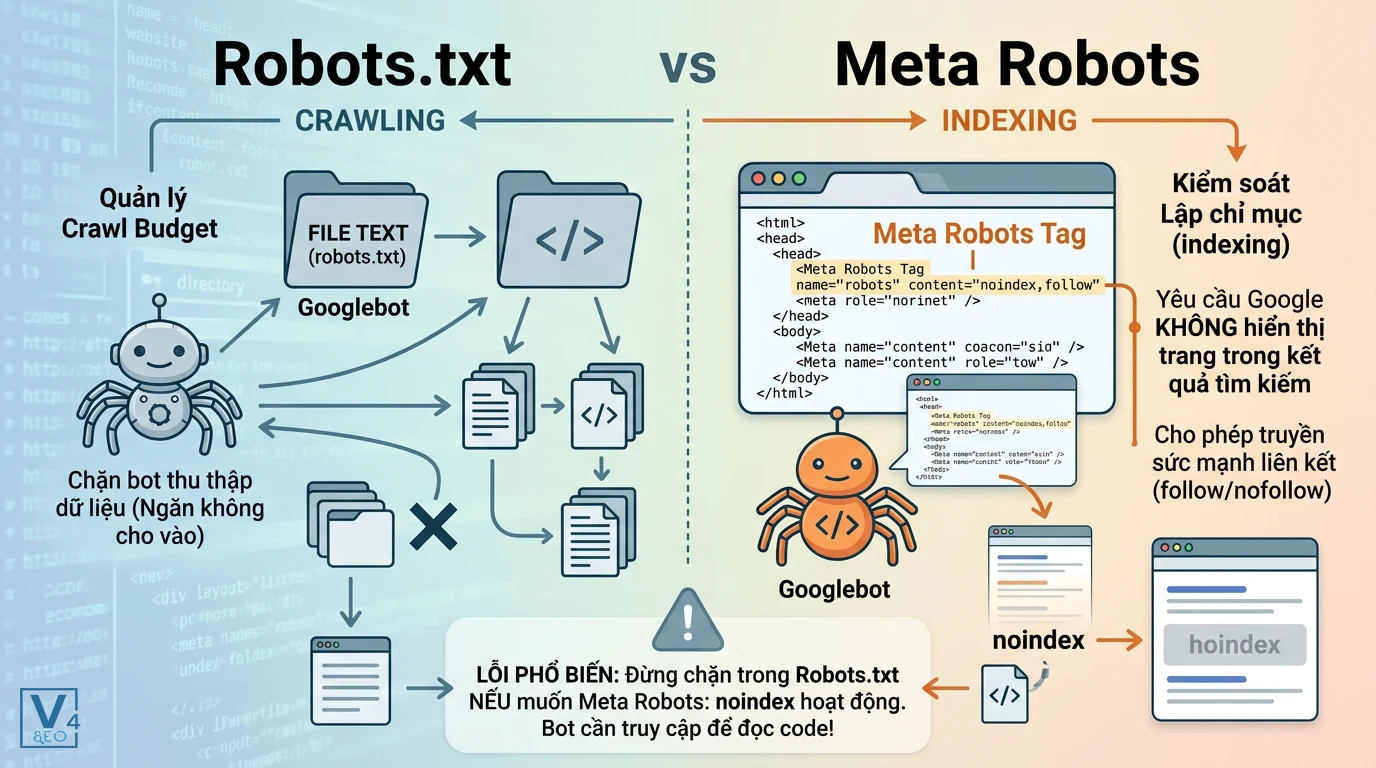
Robots.txt kiểm soát việc thu thập dữ liệu (crawling), trong khi Meta Robots kiểm soát việc lập chỉ mục (indexing). Đây là hai khái niệm hoàn toàn khác nhau nhưng lại rất dễ bị nhầm lẫn trong quá trình tối ưu hóa kỹ thuật SEO.
|
Tiêu chí so sánh |
Robots.txt |
Meta Robots |
|
Vị trí cấu hình |
File text đặt ở thư mục gốc của website |
Thẻ HTML đặt trong phần của trang |
|
Mục đích chính |
Quản lý Crawl Budget, chặn bot thu thập dữ liệu |
Kiểm soát việc lập chỉ mục và truyền sức mạnh liên kết |
|
Phạm vi ảnh hưởng |
Toàn bộ website hoặc các thư mục lớn |
Từng trang (URL) cụ thể |
Một lỗi logic kinh điển mà nhiều người làm SEO mắc phải là chặn một trang trong file robots.txt nhưng lại hy vọng thẻ noindex trên trang đó hoạt động. Nếu bạn chặn bot trong robots.txt, Googlebot sẽ không thể truy cập vào trang để đọc mã HTML, dẫn đến việc thẻ noindex bị bỏ qua hoàn toàn. Kết quả là trang vẫn có thể xuất hiện trên Google với thông báo không có mô tả.
Khi nào nên sử dụng X-Robots-Tag thay thế
X-Robots-Tag được sử dụng như một phần của phản hồi HTTP header, cho phép kiểm soát lập chỉ mục cho cả các tệp không phải HTML như PDF, hình ảnh, video hoặc các tài liệu văn phòng.
Vì thẻ meta robots thông thường chỉ hoạt động bên trong mã nguồn HTML, nó trở nên vô dụng đối với các định dạng tệp tin độc lập. Nếu bạn có một tài liệu PDF nội bộ chứa thông tin bảo mật và không muốn nó xuất hiện trên Google, bạn bắt buộc phải cấu hình X-Robots-Tag thông qua tệp .htaccess (đối với máy chủ Apache) hoặc nginx.conf (đối với máy chủ Nginx).
Cách kiểm tra và cấu hình Meta Robots trên website
Bạn có thể dễ dàng kiểm tra thẻ meta robots bằng cách xem nguồn trang (View Source) hoặc sử dụng các công cụ hỗ trợ SEO. Việc đảm bảo thẻ được cấu hình đúng sẽ giúp website tránh được tình trạng mất index hàng loạt do sai sót kỹ thuật.
Kiểm tra thủ công qua mã nguồn HTML
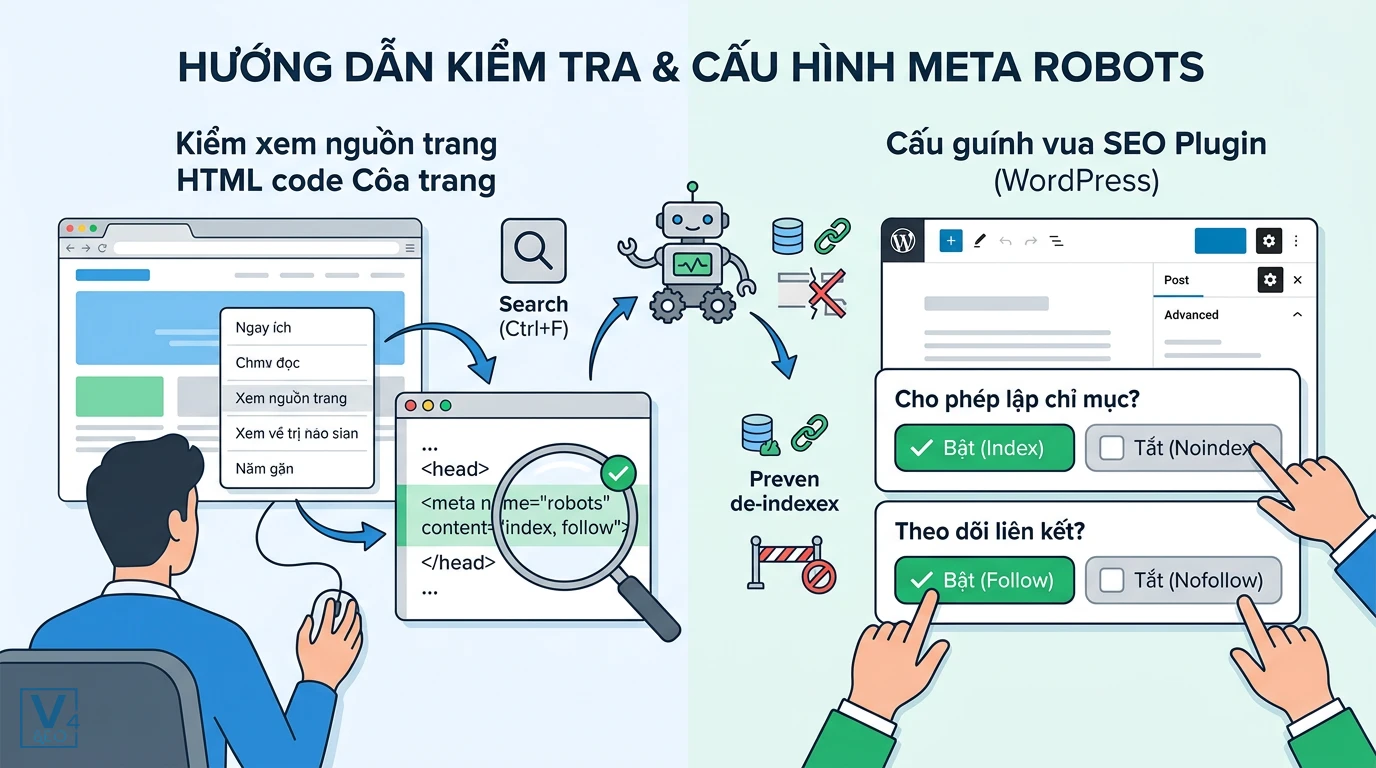
Cách nhanh nhất để xác nhận sự tồn tại của thẻ trên một trang cụ thể là kiểm tra trực tiếp mã nguồn. Bạn chỉ cần nhấp chuột phải vào trang web, chọn “Xem nguồn trang” (hoặc nhấn tổ hợp phím Ctrl+U). Sau đó, sử dụng công cụ tìm kiếm (Ctrl+F) và gõ từ khóa “robots”. Nếu trang có cài đặt, bạn sẽ nhìn thấy đoạn mã HTML nằm gọn trong phần .
Cấu hình bằng plugin SEO trên WordPress
Đối với người dùng không chuyên về lập trình, các plugin SEO trên WordPress như Yoast SEO hay Rank Math cung cấp giao diện trực quan để cấu hình thẻ này. Trong trình soạn thảo bài viết, bạn chỉ cần tìm đến hộp thoại cài đặt nâng cao (Advanced) của plugin. Tại đây, bạn có thể dễ dàng chuyển đổi các tùy chọn cho phép hoặc ngăn chặn công cụ tìm kiếm lập chỉ mục (noindex) và đi theo liên kết (nofollow) chỉ bằng vài cú click chuột.
Các câu hỏi thường gặp về Meta Robots
Dưới đây là tổng hợp các câu hỏi phổ biến nhất về thẻ meta robots và câu trả lời chuẩn xác từ chuyên gia SEO, giúp bạn xử lý nhanh các vấn đề kỹ thuật thường gặp.
Có nên dùng chung thẻ Canonical và Noindex trên một trang không
Không nên sử dụng đồng thời hai thẻ này vì chúng gửi đi các tín hiệu mâu thuẫn cho Googlebot. Thẻ Canonical gợi ý Google lập chỉ mục một phiên bản gốc, trong khi Noindex lại yêu cầu loại bỏ trang khỏi cơ sở dữ liệu. Hãy chọn một trong hai giải pháp tùy thuộc vào mục đích cụ thể của bạn.
Mất bao lâu để thẻ noindex có hiệu lực trên Google
Google cần thời gian để thu thập lại dữ liệu (recrawl) trang đó trước khi nhận diện được thẻ mới. Thời gian có thể dao động từ vài ngày đến vài tuần tùy thuộc vào tần suất thu thập dữ liệu tổng thể của website. Bạn có thể chủ động yêu cầu lập chỉ mục lại trong Google Search Console để đẩy nhanh quá trình này.
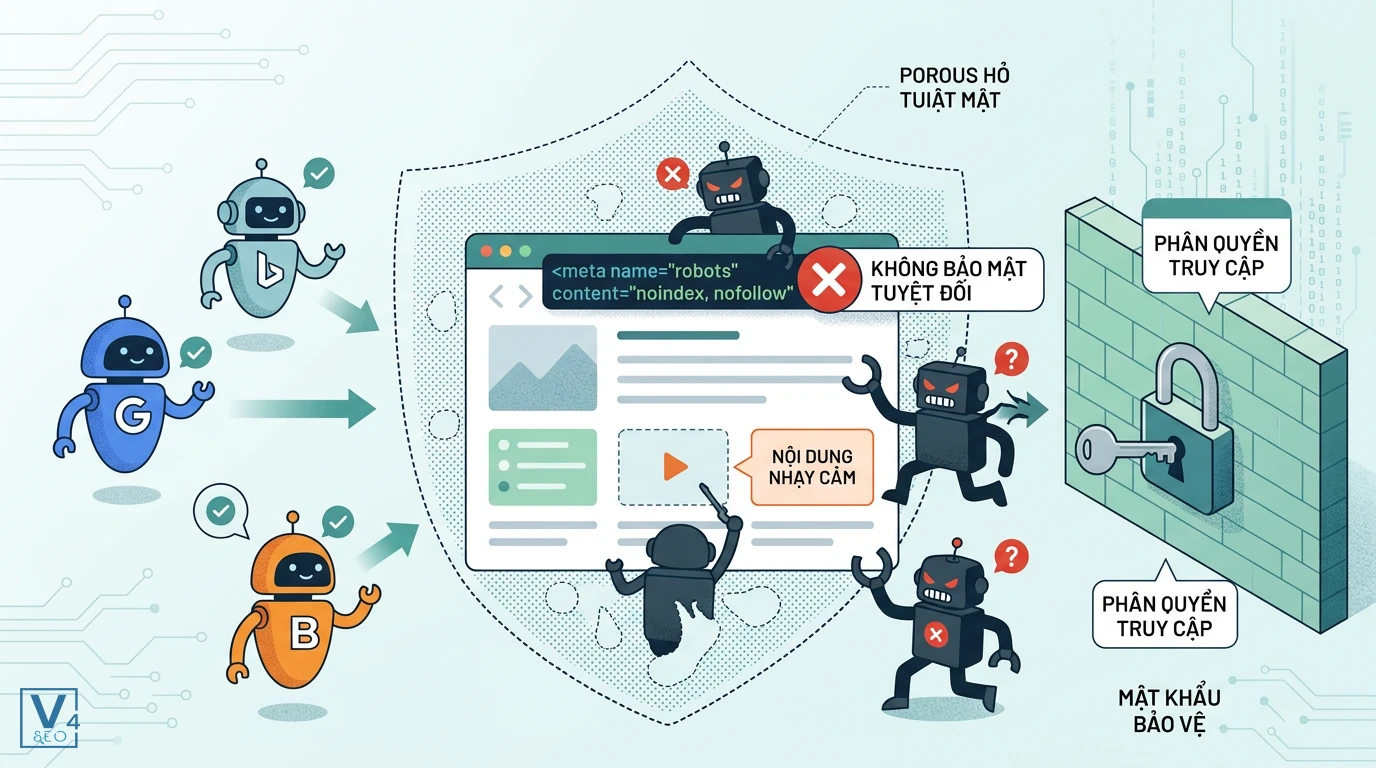
Thẻ meta robots có bảo mật thông tin trang web tuyệt đối không
Không. Thẻ này chỉ hướng dẫn các bot tìm kiếm hợp tác (như Googlebot hoặc Bingbot). Các bot độc hại, công cụ quét dữ liệu tự động (scraper) hoàn toàn có thể bỏ qua chỉ thị này và đọc nội dung trang của bạn. Để bảo mật tuyệt đối, bạn cần sử dụng các biện pháp phân quyền tài khoản hoặc đặt mật khẩu bảo vệ thư mục.
Phân biệt nofollow trong meta robots và thuộc tính rel nofollow
Nofollow trong meta robots áp dụng cho tất cả các liên kết xuất hiện trên trang đó, biến toàn bộ trang thành một ngõ cụt đối với dòng chảy sức mạnh liên kết. Trong khi đó, thuộc tính rel=”nofollow” chỉ áp dụng cho một liên kết cụ thể được chỉ định trong mã HTML, cho phép bạn kiểm soát chi tiết từng external link.
Tại sao trang cài noindex vẫn xuất hiện trong Google Search Console
Có thể do trang đang bị chặn thu thập dữ liệu trong file robots.txt khiến Google không thể truy cập để đọc thẻ noindex. Một nguyên nhân phổ biến khác là Google chưa tiến hành thu thập lại dữ liệu kể từ khi bạn thêm thẻ. Hãy sử dụng công cụ kiểm tra URL trong Search Console để xác định chính xác nguyên nhân.
Nếu bạn đang gặp khó khăn trong việc thiết lập cấu trúc kỹ thuật hoặc cần tối ưu hóa Crawl Budget chuyên sâu, đội ngũ chuyên gia tại V4SEO luôn sẵn sàng hỗ trợ. Việc cấu hình chuẩn xác ngay từ đầu sẽ tạo nền tảng vững chắc cho mọi chiến dịch SEO của doanh nghiệp.


